


📌 핵심 요약
AI 비전검사 한계는 데모보다 양산 운영 단계에서 더 분명하게 드러납니다. 신규 불량과 레시피 변경, 판정 근거 설명이 대표적인 지점입니다. 이 문제는 모델 하나를 바꾼다고 사라지지 않습니다. 보류와 검사자 리뷰, 재학습과 배포 이력을 운영 구조로 갖추면 관리할 수 있습니다.
AI 비전검사 한계는 PoC가 끝나고 모델이 라인에 올라간 다음에 드러납니다. 룰베이스 검사기를 쓰던 국내 반도체 기판(PCB) 제조 현장은 다품종과 신규 모델 전개가 잦아 검사 기준을 유지하기 어려웠습니다. 검사 방식을 AI로 바꿔도 품종과 불량은 계속 바뀝니다. PoC 보고서의 숫자가 그대로 유지된다고 볼 수 없는 이유입니다.
데모와 우리 라인의 차이는 비정형 결함, 데모와 현장이 다른 이유에서 따로 다뤘습니다. 여기서는 그다음 단계인 양산 운영의 AI 비전검사 한계만 봅니다.
AI 비전검사 한계, 오해 3가지
AI 비전검사를 둘러싼 오해는 기대를 지나치게 높이거나 도입을 미루게 만듭니다. 양산 전에 세 가지부터 바로잡아야 합니다.
불량 데이터가 많아야 한다는 오해
불량 샘플이 적어도 시작할 수 있습니다. 제조 라인은 정상 제품이 대부분이라 불량 이미지를 많이 모으기 어렵습니다. 그래서 정상 이미지만 학습해 벗어난 것을 찾는 이상 탐지(Anomaly Detection) 방식을 씁니다. 실제 결함과 비슷한 가상 결함 이미지를 만들어 학습을 보완하기도 합니다.
다만 데이터 문제가 사라지는 것은 아닙니다. 어떤 불량인지 유형까지 구분하려면 라벨이 붙은 사례가 결국 필요합니다. 처음에는 이상 탐지로 후보를 걸러 내고, 사람이 확인한 불량에 이름을 붙여 쌓아 갑니다. 이렇게 모인 사례가 늘어날수록 유형별 판정도 가능해집니다. 유형을 나눌 기준은 품질팀과 미리 정합니다. 이 기준이 있어야 학습 데이터가 일관되게 쌓입니다. 불량 데이터는 시작 조건이 아니라 운영하면서 쌓아 가는 자산입니다.
정확도 숫자로는 보이지 않는 AI 비전검사의 한계
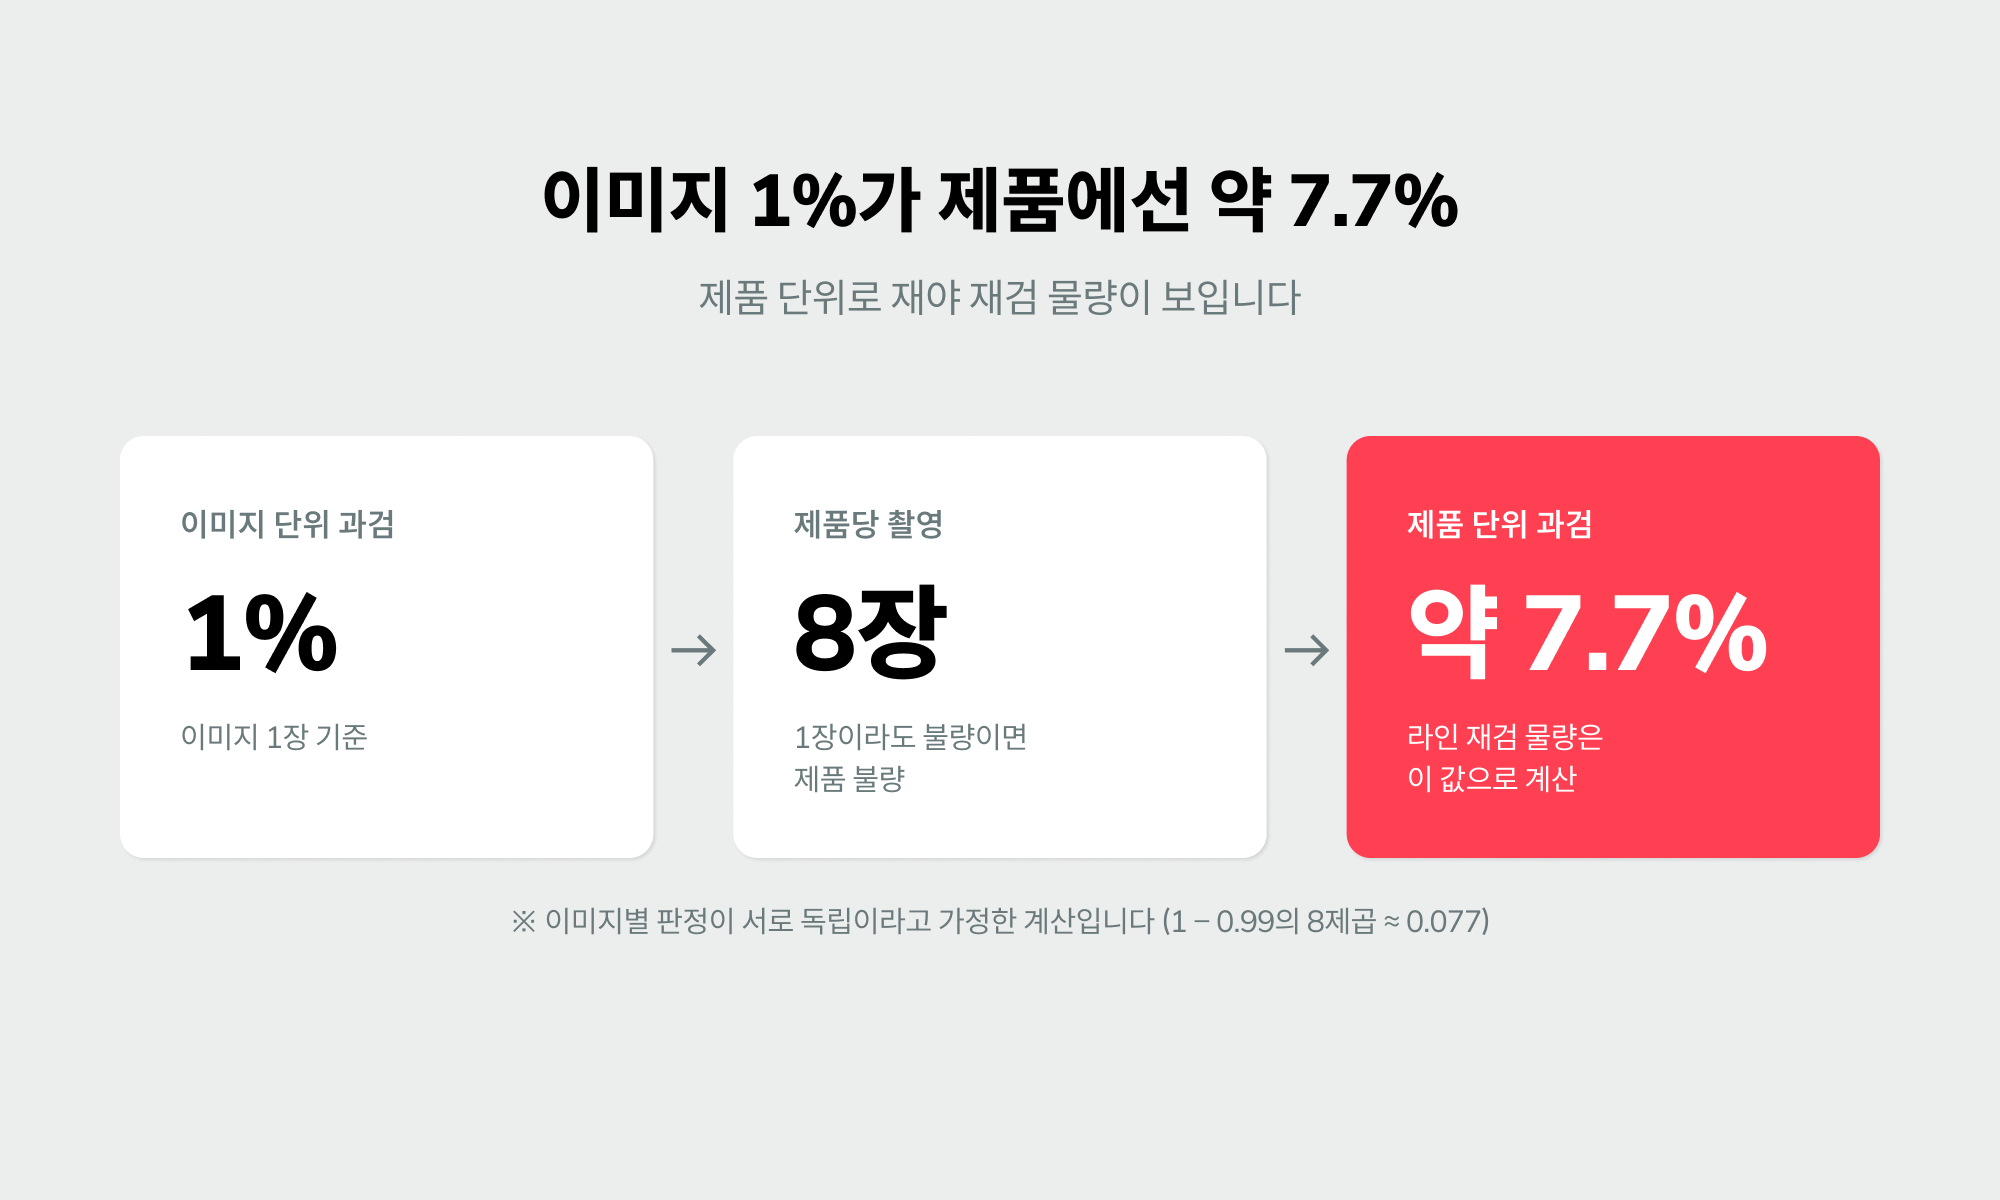
정확도는 어느 단위로 쟀는지부터 확인해야 합니다. 판정은 결함, 이미지, 제품 순으로 올라갑니다. 기본 정책은 제품을 이루는 이미지 중 1장이라도 불량이면 제품 전체를 불량으로 보는 방식입니다.
이미지 단위 과검이 1%이고 제품 하나를 8장으로 촬영한다고 가정해 보겠습니다. 이미지별 판정이 서로 독립이라면 제품 단위 과검은 약 7.7%까지 올라갑니다. 1%라는 숫자만 보고 라인 재검 물량을 계산하면 크게 어긋납니다.
과검은 AI가 불량이라 했는데 사람이 양품으로 바꾼 것입니다. 미검은 AI가 양품이라 했는데 사람이 불량으로 바꾼 것입니다. 측정 방법은 AOI 과검률을 다룬 글에서 이어서 볼 수 있습니다.
🏭 세이지 적용 현장에서 확인한 수치 (고객사 정보는 익명 처리)
룰 기반 AOI 뒤에 AI 필터를 더한 세이지 적용 현장에서는 과검률이 3% 수준이었고, 결함 후보의 80%를 자동 판정했습니다. 이 값은 해당 라인의 조건에서 나온 결과라 다른 라인에 그대로 옮길 수 없습니다.
사람이 필요 없어진다는 오해
AI 검사가 안정돼도 사람의 자리는 남습니다. 달라지는 것은 사람이 보는 물량과 역할입니다. 위 세이지 적용 현장에서도 결함 후보의 20%는 육안 재검으로 남았습니다.
사람은 모든 제품을 보는 대신 애매한 판정을 확인하고 새 불량을 발견합니다. 검사자가 고친 결과는 다음 학습의 정답 데이터가 됩니다. 사람을 아예 빼면 모델을 고칠 근거도 함께 사라집니다.
양산 뒤 AI 비전검사 한계가 나오는 지점
양산 뒤의 문제는 성능표에 없던 변화에서 시작됩니다. 변화가 생기는 지점을 미리 정해 두면 대응이 빨라집니다.
신규 불량, AI 비전검사의 한계가 먼저 드러나는 곳
학습하지 않은 불량은 놓치거나 엉뚱한 유형으로 분류될 수 있습니다. 2026년 AI 머신비전 컨퍼런스의 세이지 발표도 CNN과 ViT 계열 모델은 처음 보는 상황이 나오면 다시 학습해야 한다고 정리했습니다. 이상 탐지는 정상에서 벗어난 것을 올려 주지만, 그 결함에 이름을 붙이는 일은 따로 남습니다.
불량이 아닌데 불량처럼 보이는 경우도 있습니다. 구축이 진행 중인 광학 렌즈 제조 현장에서는 표면 먼지로 인한 과검 가능성이 과제로 꼽혔습니다. 양산이 길어질수록 이런 예외는 늘어나므로, 새 유형을 모으는 경로가 필요합니다. 현장에서 처음 보는 결함이 나오면 이미지와 함께 발생 시점과 라인을 기록합니다. 비슷한 사례가 몇 건 모였을 때 결함 이름을 정하고 학습에 넣습니다. 기록이 쌓이면 어떤 공정에서 새 결함이 자주 나오는지도 보입니다.
레시피 변경 뒤 달라지는 판정
레시피 변경의 위험은 공정 유형에 따라 다릅니다. 변경이 잦은 라인일수록 모델 점검 시점을 먼저 정해야 합니다.
| 구분 | 연속 공정 | 배치 공정 |
|---|---|---|
| 예시 | 컨베이어·식품·제지 | 로트 단위·반도체·PCB |
| 레시피 변경 | 적음 | 잦음 |
| 먼저 볼 지표 | 시간대별 과검·미검 추이 | 로트별 과검·미검 비교 |
레시피가 바뀌면 이미지의 밝기와 패턴이 달라질 수 있습니다. 같은 모델을 그대로 써도 과검이 갑자기 늘어나는 이유입니다. 로트 ID가 붙어 있으면 어느 로트부터 결과가 달라졌는지 통계로 좁힐 수 있습니다. 레시피를 바꾸기 전에 바뀌는 조건과 예상 영향을 품질 담당자와 공유합니다. 변경 직후 며칠은 보류 비율을 따로 보면 판정이 흔들리는 지점을 빨리 찾을 수 있습니다. 필요하면 새 조건의 이미지를 모아 다시 학습합니다. 변경 이력은 로트 기록과 함께 보관합니다.
판정 근거 설명, AI 비전검사의 한계가 남는 자리
고객사 품질 감사에서 왜 불량으로 봤는지 물으면 점수만으로는 답하기 어렵습니다. 모델 구조마다 강점과 약점이 다릅니다.
| 항목 | CNN | ViT | VLM |
|---|---|---|---|
| 속도 | 매우 빠름 | 빠름 | 느림 |
| 처음 보는 상황 | 다시 학습 | 다시 학습 | 말로 알려 주면 대응 |
| 이유 설명 | 점수만 냄 | 점수만 냄 | 문장으로 설명 |
| 약점 | 맥락 이해가 약함 | 데이터·연산이 많이 듦 | 느리고 가끔 그럴듯한 오답 |
출처: 세이지 대표 발표, 2026 AI 머신비전 컨퍼런스 (2026.10.16)
VLM(비전 언어 모델)이 답처럼 보이지만, 머신비전에 적용하는 일은 아직 개발·검토 단계입니다. 그럴듯한 오답이 있어 고속 라인의 1차 판정을 맡기기는 어렵습니다. 기존 모델이 올린 결과를 2차 재판단하고 근거를 설명하는 역할로 검토되고 있습니다.
AI 비전검사 한계를 운영으로 줄이는 법
AI 비전검사 한계를 모델 개선만으로 넘기는 어렵습니다. 양산 라인에서는 운영 구조가 성패를 가릅니다.
보류와 검사자 리뷰로 AI 비전검사의 한계 메우기
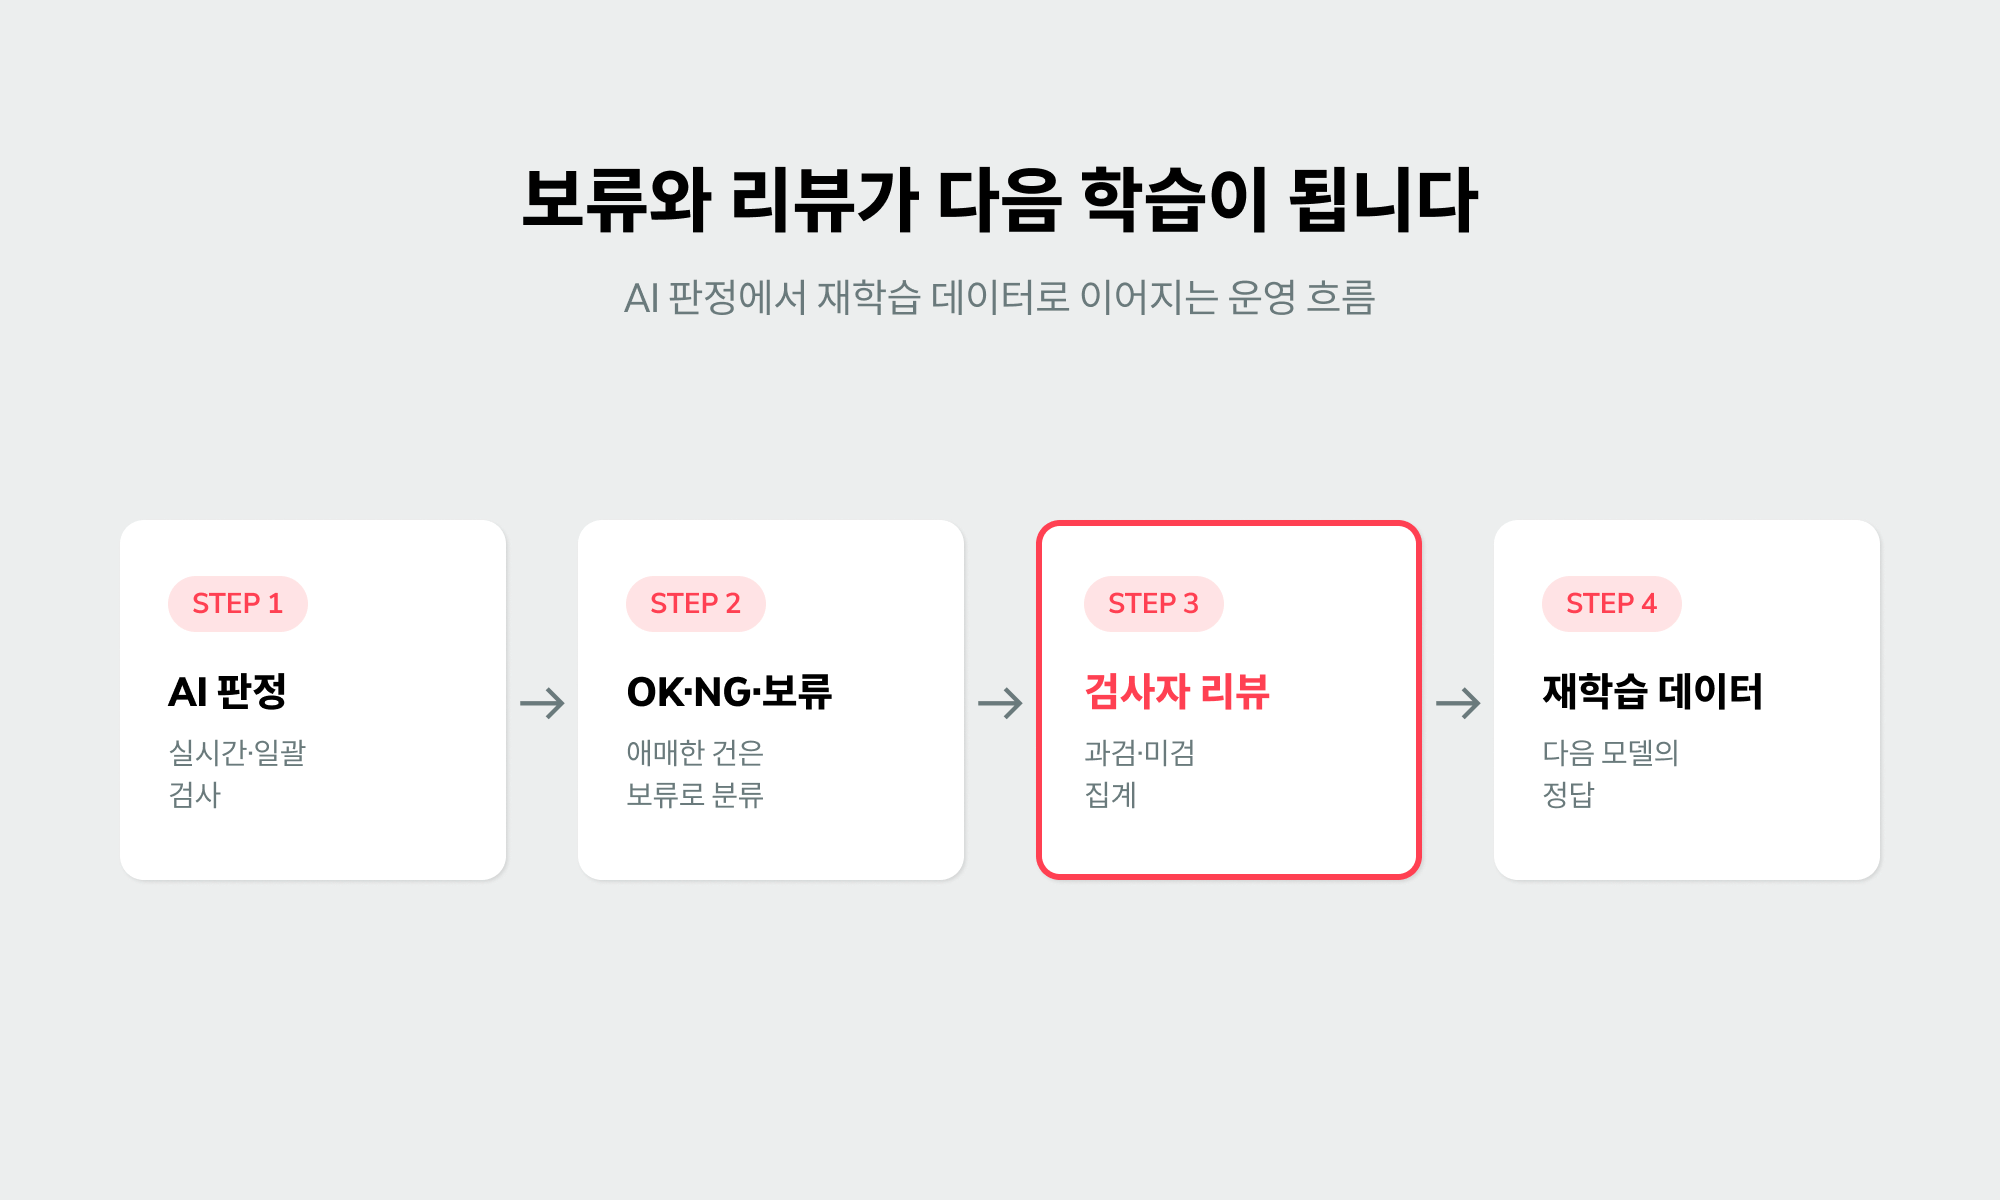
판정을 OK와 NG로만 나누면 애매한 제품이 갈 곳이 없습니다. 보류(Hold)는 AI 판정과 별개로, 공정 후처리 조건에 따라 사람이 다시 볼 것으로 분류한 상태입니다. 앞서 본 PCB 제조 현장도 결과를 OK·NG·재검으로 나누고 재확인이 필요한 항목만 육안검사로 넘겼습니다.
검사자 리뷰는 실시간 검사와 일괄 검사 어디에든 붙일 수 있습니다. 리뷰 결과가 쌓이면 과검과 미검이 집계되고, 재학습 후보도 함께 모입니다. 보류 건을 누가, 언제까지 처리할지 정하지 않으면 리뷰 대기열이 쌓입니다. 교대마다 담당자를 정하고 처리 결과를 한곳에 남기도록 운영 규칙을 만듭니다. 리뷰어끼리 판정이 갈린 건은 기준서에 예시로 추가합니다. 처리 시간이 길어지는 건은 원인을 따로 표시해 다음 회의에서 다룹니다. 대기열 길이도 매주 확인합니다.
재학습과 배포 이력
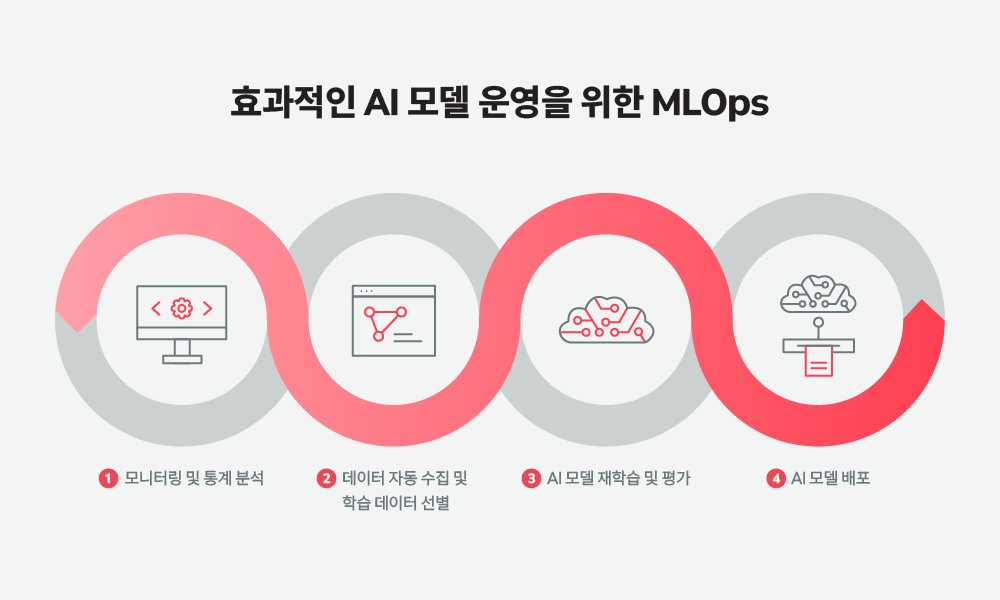
재학습은 정기 행사가 아니라 조건이 생겼을 때 하는 작업입니다. 신규 불량 유형이 나왔을 때, 레시피가 바뀌었을 때, 과검·미검 추이가 나빠졌을 때를 기준으로 삼습니다.
새 모델을 올린 뒤 결과가 나빠지면 어떤 버전이 언제 배포됐는지 바로 찾아야 합니다. 그래서 결재 문서에는 정확도 목표와 함께 운영 책임자, 재학습 조건, 되돌림 기준을 적어야 합니다. 도입 비용만큼 실패했을 때의 대응 경로가 결재의 근거가 됩니다.
SAIGE VISION은 데이터 관리와 라벨링, 모델 학습, 배포를 한 곳에서 다룹니다. MLOps 기능으로 모델 모니터링, 데이터 수집·관리, 배포·버전 관리를 지원합니다. 현장 설치형으로 운영하므로 검사 이미지가 회사 밖으로 나가지 않습니다. 배포 전후 성능은 같은 기준 이미지로 비교해 기록합니다.
AI 비전검사 한계 자주 묻는 질문
측정 단위와 조건을 확인하기 전에는 판단할 수 없습니다. 이미지 단위인지 제품 단위인지, 과검과 미검을 나눠 쟀는지부터 봐야 합니다. 어떤 기간과 로트의 데이터로 쟀는지도 함께 확인합니다.
CNN과 ViT 계열 모델의 출력이 대부분 점수이기 때문입니다. 점수는 판정 결과를 알려 주지만 이유를 문장으로 말해 주지는 않습니다. 현장에서는 결함 위치 표시와 검사자 리뷰 기록으로 이를 보완합니다.
사라지지 않습니다. VLM은 이유를 문장으로 설명할 수 있지만 속도가 느리고 가끔 그럴듯한 오답을 냅니다. 머신비전에서는 기존 모델을 대신하기보다 보완하는 방향으로 검토되고 있습니다.
SAIGE VISION의 MLOps 기능으로 모델 배포와 버전을 관리합니다. 모델 모니터링과 데이터 수집·관리도 같은 흐름에서 다룰 수 있습니다. 라인별 운영 방식은 샘플 테스트와 현장 협의 단계에서 함께 정합니다.
AI 비전검사 한계 핵심 요약
- 불량 데이터가 적어도 시작할 수 있지만, 유형 구분에는 라벨이 붙은 사례가 쌓여야 합니다.
- 정확도는 제품 단위 과검·미검으로 나눠서 봐야 라인 재검 물량을 예측할 수 있습니다.
- 신규 불량, 레시피 변경, 판정 근거 설명은 양산 뒤에 드러나는 대표 지점입니다.
- 보류와 검사자 리뷰, 재학습 조건과 배포 이력을 운영 구조로 갖춰야 합니다.
📚 함께 읽으면 좋은 글
- 품질검사 자동화 단계 정하는 법: 육안부터 AI까지 기존 라인에서 시작하기 — 어느 공정부터 자동화할지 판단할 때
- 비전검사기 업그레이드, 장비를 바꾸지 않고 AI 판정만 더하는 법 — 기존 검사기를 살릴 때
- 육안검사 인력이 줄면 야간 검사는 어떻게 될까 — 사람이 남을 자리를 정할 때
참고 출처
- 세이지 대표 발표, AI 품질 검사의 확장 방향 (2026 AI 머신비전 컨퍼런스, 2026.10.16)
- SAIGE VISION 제품 페이지
- 룰베이스 검사의 과검을 줄인 PCB 외관검사 사례
- 렌즈 외관 검사 자동화 사례 (구축 진행 중)
© SAIGE All Rights Reserved.